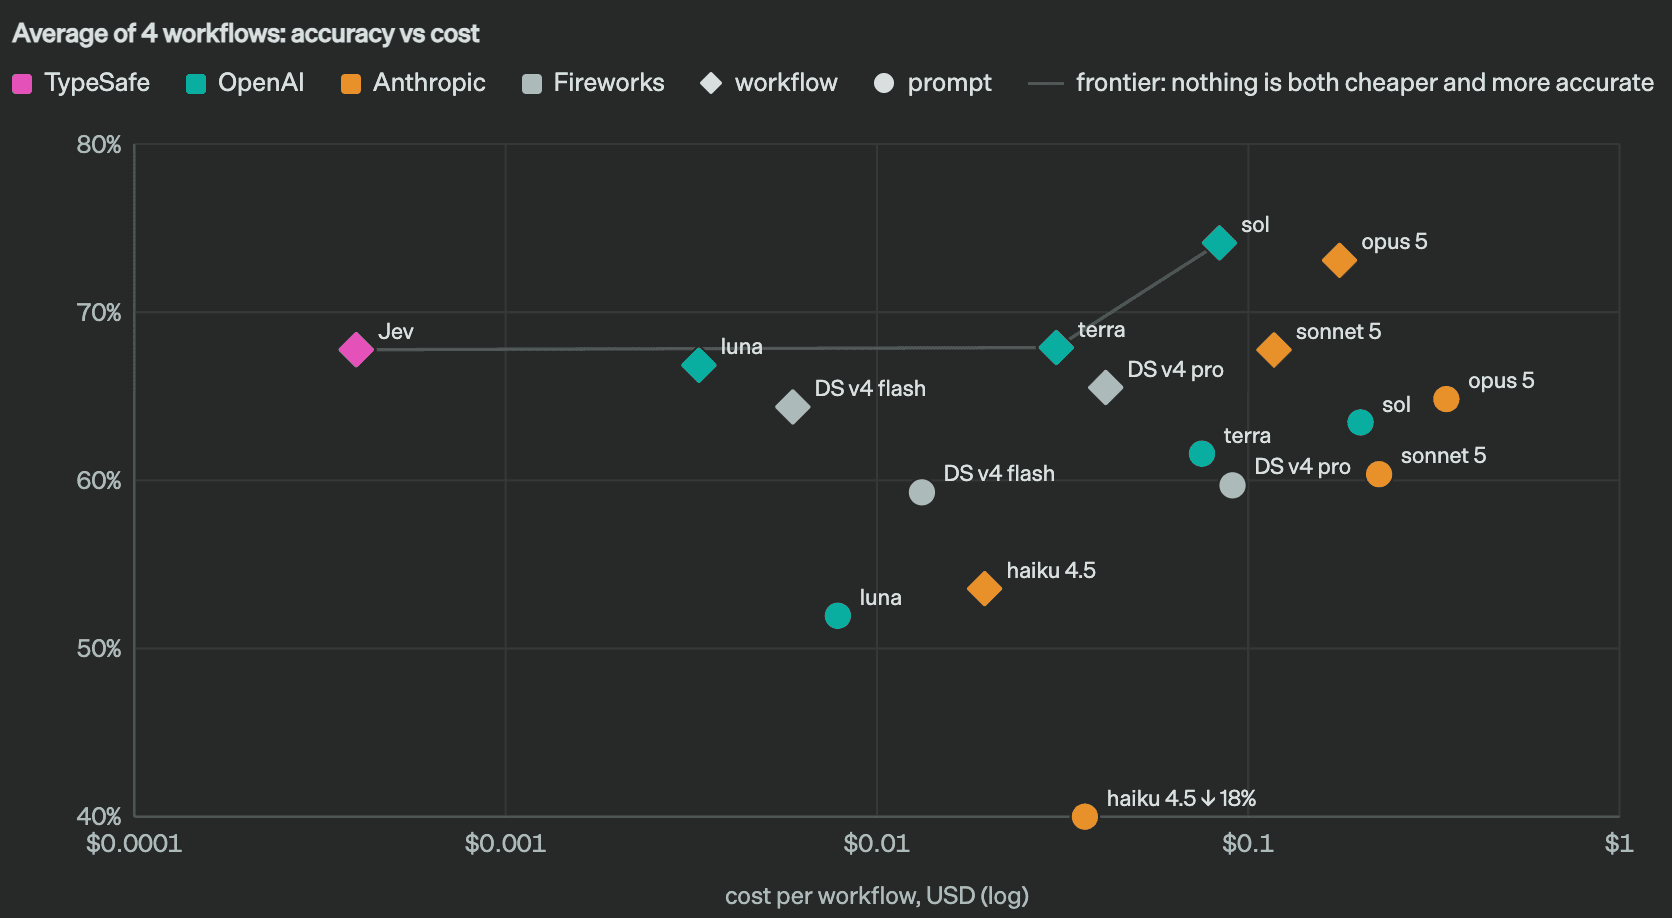
Un logiciel n’a pas toujours besoin qu’une intelligence artificielle lui écrive quelque chose. Il peut simplement avoir besoin de savoir si un dossier doit être transmis, quelle action lancer, quel élément sélectionner dans une interface ou si une situation mérite l’intervention d’un humain. Pourtant, avec les grands modèles de langage, ces décisions passent encore souvent par une génération : le modèle produit quelques tokens, une chaîne de caractères ou du JSON, que le programme doit ensuite interpréter avant d’agir.
Depuis le 15 septembre 2026, TypeSafe propose une autre approche avec Jev. Le lendemain apparaissait SemIf, projet open source initialement baptisé OpenJev. Les deux suivent une intuition commune : lorsqu’un programme attend une décision parmi un ensemble de possibilités connues, la génération de langage n’est pas forcément la meilleure interface entre le modèle et le code.
Pour le moment, je vois surtout là une technologie de niche, particulièrement intéressante pour les développeurs et certains environnements professionnels. Mais elle ouvre aussi une piste plus large : utiliser la probabilité non plus simplement comme une information interne au modèle, mais comme un moyen de décider précisément jusqu’où l’entreprise souhaite laisser agir la machine.
Avec Jev, la réponse disparaît
TypeSafe présente Jev comme son premier « System One Model ». L’entreprise ne cherche pas à construire un nouveau chatbot. Le modèle reçoit un état, des questions ou critères définis par le programme et un ensemble de sorties possibles. Il renvoie directement des décisions typées accompagnées de probabilités.
On peut imaginer un système chargé d’orienter automatiquement une demande client. Le programme fournit le contenu de la demande et définit trois possibilités : facturation, accès au compte ou intervention humaine. Jev n’a pas à rédiger « Je pense que cette demande concerne probablement l’accès au compte ». Il doit attribuer une probabilité aux possibilités qui lui ont été données et renvoyer un résultat exploitable directement par le logiciel.
TypeSafe décrit pour cela une nouvelle architecture, un mécanisme d’échantillonnage parallèle et une méthode d’entraînement baptisée RLCD, Reinforcement Learning for Calibrated Decisions. Le choix n’est plus produit par une génération autorégressive classique, dans laquelle chaque token dépend des précédents. Les différentes sorties sont évaluées dans la même requête et l’objectif annoncé de l’entraînement porte directement sur des décisions probabilistes calibrées.
Le déplacement est important. Dans une architecture utilisant un LLM généraliste, le programme doit généralement transformer son problème en instruction, attendre une génération, récupérer la sortie puis vérifier qu’elle respecte le format attendu. Avec Jev, les sorties autorisées appartiennent déjà au contrat passé entre le programme et le modèle.
TypeSafe annonce actuellement entre 70 et 500 millisecondes de réponse selon ses requêtes et revendique, sur certains de ses workflows, des gains pouvant atteindre 193,6 fois en vitesse et 444,6 fois en coût. Ces chiffres proviennent des propres évaluations de l’entreprise et TypeSafe indique elle-même qu’ils correspondent probablement au haut de la fourchette des gains observables en situation réelle.
Ce qui m’intéresse davantage se trouve dans la manière dont cette architecture peut s’intégrer au logiciel. Une décision n’est plus seulement oui ou non. Elle peut être oui : 0,97, non : 0,03. Cette différence paraît minuscule à l’écran. Dans du code métier, elle change beaucoup de choses.
SemIf prend un chemin beaucoup plus direct
SemIf est arrivé sur GitHub dès le 16 septembre. Au relevé effectué le 21 septembre 2026, le dépôt comptait 2 739 étoiles et 173 forks, seulement cinq jours après sa création.
Il ne reproduit pourtant pas Jev. Son auteur est très clair sur ce point : SemIf reproduit le mode d’interaction, pas le modèle ni l’entraînement de TypeSafe. Il utilise des modèles ouverts classiques, notamment Qwen3.5-4B, MiniCPM5-2B ou Qwen3-0.6B.
C’est précisément ce qui le rend intéressant.
Un modèle de langage causal calcule, avant même de générer son prochain token, un score pour les différents tokens de son vocabulaire. Ces valeurs brutes sont les logits. Lors d’une génération classique, ces scores sont transformés en probabilités, un token est sélectionné, puis le processus recommence pour le token suivant.
SemIf s’arrête avant cette dernière étape.
Les choix proposés au modèle sont associés à des lettres, de A jusqu’à P. Une instruction lui demande de sélectionner exactement une de ces options. Le programme effectue alors un passage dans le modèle, récupère directement les logits du dernier emplacement pour les tokens correspondant à ces lettres, puis applique une fonction softmax afin d’obtenir une distribution de probabilités entre les options.
Le modèle ne produit donc aucun token de réponse.
L’état entre dans Qwen. Le modèle calcule ses scores internes. SemIf récupère directement ceux qui correspondent aux réponses possibles. La boucle de décodage autorégressive disparaît.
L’expérience publiée avec Qwen3.5-4B permet de mesurer concrètement ce que cela change. Sur une RTX 3090, avec le même modèle gelé, le même état et 21 décisions binaires, SemIf obtient ses 21 paires de probabilités en 1,023 seconde en médiane. Demander au même modèle de générer un tableau JSON compact contenant les 21 réponses demande 5,332 secondes. La génération produit 111 tokens de sortie, contre zéro pour la lecture directe. Les décisions finales coïncident sur 18 des 21 critères.
SemIf démontre ainsi que ce nouveau paradigme n’exige pas nécessairement une nouvelle famille de modèles pour fonctionner. Une partie de l’information recherchée existe déjà dans les modèles généralistes. Il est possible d’aller la récupérer avant qu’elle ne soit transformée en langage.
Pour moi, cela ne retire cependant rien à l’intérêt d’un modèle spécifiquement conçu pour cette fonction. Au contraire.
Le modèle généraliste comme preuve de concept, le modèle spécialisé pour le travail
SemIf montre ce qu’un LLM existant peut faire lorsqu’on change la manière d’exploiter sa sortie. Son propre code décrit cependant les probabilités obtenues comme des scores conditionnels entre les options proposées, et non comme une confiance décisionnelle déjà calibrée.
C’est précisément là que je vois l’intérêt d’une architecture spécialisée comme celle que TypeSafe cherche à construire avec Jev.
Dans un environnement professionnel répétitif, le but n’est pas nécessairement de posséder un modèle capable de rédiger un poème, d’expliquer la relativité générale, de traduire du japonais et d’analyser un contrat. Si la fonction demandée consiste plusieurs millions de fois par jour à classer, router, valider ou choisir entre quelques actions, je préfère l’idée d’un modèle entraîné spécifiquement pour cette fonction.
La vitesse compte. Le coût aussi. Mais la spécialisation permet surtout d’envisager un système dans lequel les probabilités font partie intégrante de la logique métier.
Cela n’a pas forcément beaucoup de sens pour le grand public. Un utilisateur classique veut pouvoir ouvrir une interface, poser une question imprécise, changer complètement de sujet deux minutes plus tard, demander une traduction puis faire analyser une photographie. La polyvalence des LLM est ici un avantage majeur. Multiplier les modèles spécialisés rendrait l’expérience plus compliquée sans bénéfice évident pour l’utilisateur.
Dans une entreprise, le problème est différent. Les tâches sont souvent connues, répétitives et délimitées. C’est précisément dans ce contexte qu’un modèle spécialisé dans la décision me paraît plus pertinent.
La probabilité peut rendre une partie du contrôle à l’humain
Prenons un exemple volontairement simple. Une entreprise automatise le contrôle d’un type de dossier. Elle pourrait définir trois niveaux de fonctionnement :
- une probabilité supérieure à 98 % autorise l’exécution automatique ;
- entre 80 et 98 %, la décision doit être validée par un salarié ;
- en dessous de 80 %, le dossier revient entièrement à un opérateur humain.
Les chiffres seraient naturellement différents selon l’activité, les risques et les performances réelles du modèle. L’intérêt se trouve dans le principe.
Le développeur ou l’entreprise ne demande plus seulement à l’intelligence artificielle de prendre une décision. Il définit dans quelles conditions elle a le droit de la prendre seule.
J’y vois un intérêt particulièrement fort dans les secteurs où une mauvaise manipulation de l’IA peut avoir des conséquences concrètes. Le système peut connaître les seules actions qui lui sont accessibles, leur attribuer une probabilité puis être empêché d’aller plus loin lorsque le niveau de confiance défini par l’entreprise n’est pas atteint.
L’espace d’action est également borné par le programme. Si trois opérations sont autorisées, le modèle choisit parmi ces trois opérations. Il ne construit pas librement une quatrième commande qu’un logiciel tenterait ensuite d’interpréter. TypeSafe place cette propriété au centre de Jev : les sorties possibles et leur structure sont définies à l’avance.
Cette logique trouve déjà une application assez parlante dans browser-use/jev-ultrafast. L’agent observe les éléments disponibles dans une page, puis Jev choisit une opération et sa cible. Un petit modèle génératif n’est appelé que lorsqu’il devient réellement nécessaire de produire du texte, par exemple pour remplir un champ. L’équipe a montré une recherche Google Flights exécutée en 7,073 secondes. Son benchmark reste volontairement limité, avec seulement trois répétitions sur cette tâche pour chaque configuration, mais l’architecture illustre très bien la séparation entre décider et générer.
Au relevé du 21 septembre, ce dépôt avait déjà atteint 13 774 étoiles et 850 forks. L’intérêt suscité en quelques jours ne garantit évidemment pas qu’une architecture s’imposera, mais il montre que le problème auquel elle tente de répondre parle immédiatement à une partie des développeurs.
Une niche, mais une niche qui répond à un vrai problème
Je ne vois pas Jev ou SemIf remplacer les grands modèles généralistes. Je ne pense même pas que ce soit la bonne manière de poser la question.
Les LLM excellent justement lorsqu’on ne connaît pas à l’avance la forme exacte de ce que l’on va leur demander. Leur capacité à générer du langage leur donne cette souplesse. Jev et SemIf deviennent intéressants dans le cas inverse : lorsque le problème est suffisamment défini pour que le programme connaisse déjà les possibilités et n’attende plus du modèle qu’une décision.
Pour le moment, cela reste donc à mes yeux un paradigme principalement destiné aux développeurs. Son potentiel professionnel me paraît néanmoins réel, précisément parce qu’il offre quelque chose que la course aux modèles généralistes ne place pas toujours au premier plan : un contrôle plus fin sur la frontière entre ce que la machine peut décider seule et ce qui doit revenir à un humain.
SemIf montre que l’idée peut fonctionner avec des modèles existants. Jev pousse plus loin la logique en cherchant à construire un modèle directement spécialisé pour elle. Dans un environnement professionnel, c’est cette deuxième voie qui me paraît la plus intéressante à terme.
La promesse n’est alors pas simplement d’automatiser davantage. Elle est presque inverse : définir beaucoup plus précisément ce que l’on accepte d’automatiser.
Un système connaît ses choix autorisés. Il fournit une probabilité. Le programme impose ses seuils. Et lorsque l’incertitude devient trop importante, l’humain reprend la main.
C’est peut-être là que ces modèles ont le plus à apporter : non pas donner davantage de liberté à l’intelligence artificielle, mais permettre de décider exactement combien on souhaite lui en laisser.